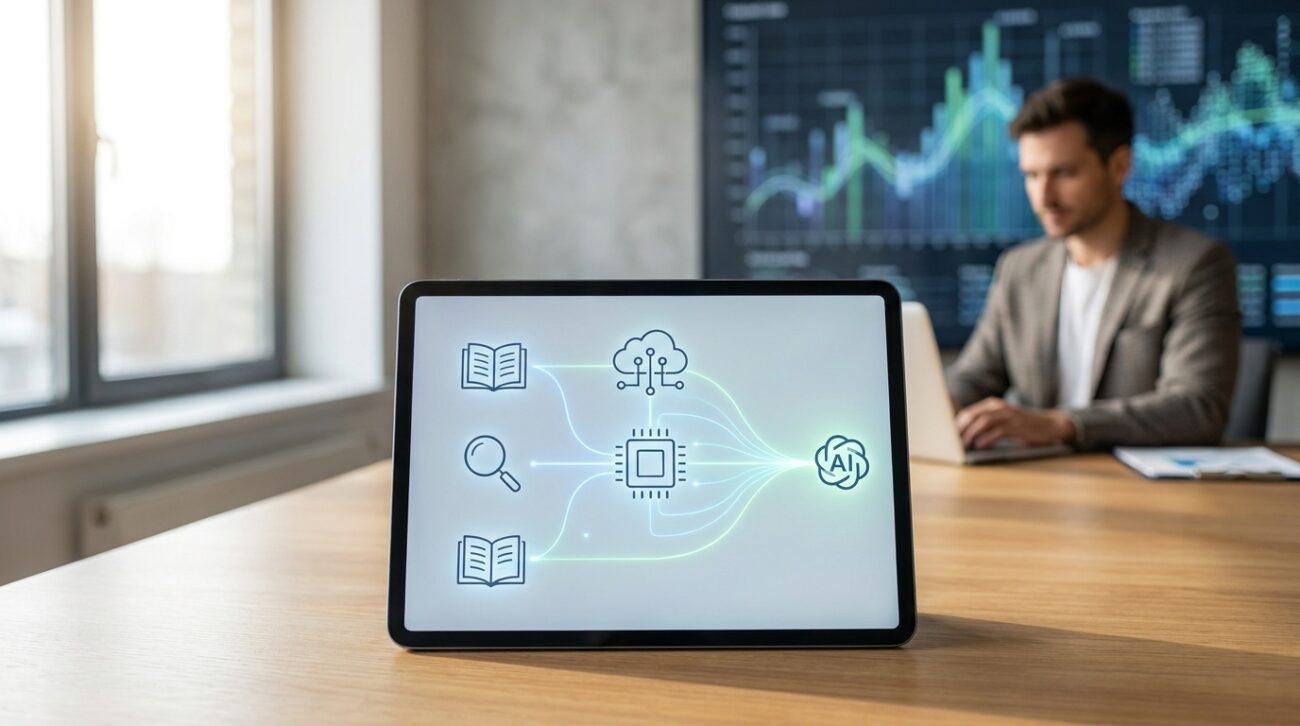
Sztuczna inteligencja zmienia oblicze operacyjne nowoczesnych przedsiębiorstw, ale modele językowe (LLM) pozostawione same sobie niosą ogromne ryzyko biznesowe. Największymi problemami są tzw. halucynacje (zmyślanie faktów), nieznajomość specyfiki firmy oraz brak dostępu do aktualnych procedur czy cenników. Rozwiązaniem, które na zawsze zrewolucjonizowało rzetelność sztucznej inteligencji, jest technologia RAG (Retrieval-Augmented Generation).
Jeśli chcesz szybko zorientować się w dostępnych opcjach, najłatwiej zacząć od najważniejszych różnic, a dopiero później przechodzić do szczegółów. Na stronie znajdziesz 5 elementów opisanych w podobnym układzie, co ułatwia szybkie porównanie najważniejszych cech. Dla wygody zebrałem obok siebie Nazwa / Podmiot, Wyróżnik / Cecha oraz Przeznaczenie, tak aby pierwsze porównanie nie wymagało czytania wszystkich opisów.
Jeżeli któraś opcja zwróci Twoją uwagę, niżej znajdziesz jej szerszy opis z dodatkowymi informacjami. Zestawienie pomaga w pierwszym rozeznaniu, ale aktualne szczegóły zawsze warto sprawdzić przed podjęciem decyzji.
Dzięki tej architekturze wewnętrzne chatboty korporacyjne, systemy prawne i asystenci obsługi klienta opierają swoje odpowiedzi wyłącznie na zweryfikowanej i aktualnej dokumentacji firmowej. Z poniższego artykułu dowiesz się, jak RAG działa pod maską, z jakimi kosztami należy się liczyć w polskich realiach oraz komu na rynku powierzyć wdrożenie takich systemów.
Co to jest? (Definicja)
Retrieval-Augmented Generation (RAG) to architektura systemów sztucznej inteligencji, która łączy generatywne zdolności modeli językowych z zewnętrznymi wyszukiwarkami baz danych. Mechanizm działania polega na tym, że model AI przed udzieleniem odpowiedzi nie opiera się na własnej „pamięci” z czasów trenowania (wiedza parametryczna), ale funkcjonuje na zasadzie „egzaminu z otwartą książką”. Najpierw przeszukuje aktualne dokumenty przedsiębiorstwa, odnajduje odpowiednie fragmenty, a dopiero na ich podstawie generuje precyzyjną i merytorycznie bezbłędną odpowiedź dla użytkownika.
Zestawienie sprawdzonych integratorów RAG w Polsce (2026)
Czytaj więcejZwiń
Szczegółowa Analiza i Przegląd
Boring Owl – Firmy z sektora PropTech oraz FinTech
Boring Owl to doceniany polski software house koncentrujący się na dedykowanych rozwiązaniach z użyciem sztucznej inteligencji opartej o mechanizm Retrieval-Augmented Generation. Zespół wykazuje ogromną biegłość w zaawansowanych ekosystemach wdrożeniowych dla branży PropTech (nieruchomości) oraz FinTech (finanse). Renoma i oceny rynkowe wyraźnie wskazują, że potrafią idealnie zoptymalizować bazy dokumentów z zachowaniem rygoru bezpieczeństwa danych.
Cechy
- ✓ Specjalizacja w kluczowych branżach finansowych (FinTech)
- ✓ Głęboka analiza bazy wejściowej i eliminacja halucynacji
- ✓ Wysoki standard wdrożeniowy potwierdzony przez środowisko
Uwagi
- ✕ Wysoki próg kosztów dla najmniejszych podmiotów w pełni customowych aplikacjach
Luqam – Firmy przemysłowe i przedsiębiorstwa z halami produkcyjnymi
Luqam wyspecjalizował się we wprowadzaniu asystentów działających na wewnętrznych procedurach operacyjnych, instrukcjach stanowiskowych oraz audytach sprzętu technicznego. To jeden z najciekawszych polskich podmiotów dla firm przemysłowych, wdrażający bezwzględnie prywatne modele RAG, do których spływa ciężka, przemysłowa dokumentacja z hal produkcyjnych.
Cechy
- ✓ Specjalizacja produkcyjno-przemysłowa
- ✓ Wysoki stopień prywatności tworzonych asystentów
- ✓ Zrozumienie specyfiki dokumentacji technicznej
Uwagi
- ✕ Rozwiązania bardzo wysoce sprofilowane na konkretną branżę (Przemysł)
Foxnet Polska – Instytucje regulowane, banki i korporacje medyczne
Foxnet Polska jest potężnym partnerem m.in. dla polskiego sektora instytucjonalnego. To software house, który przy każdej implementacji stawia na szali najwyższe wymogi compliance – wdrożenia oparte na strategii bezpieczeństwa Zero Trust gwarantują, że dane przetwarzane przez system wektorowy nigdy nie wyciekną do korporacji zewnętrznych trenujących modele językowe.
Cechy
- ✓ Bezwzględna jakość bezpieczeństwa oparta o metodologię Zero Trust
- ✓ Kompleksowe doradztwo w ramach NIS2
- ✓ Doskonałe opinie użytkowników w sieci na stanowiskach zarządczych IT
Uwagi
- ✕ Bardzo długi czas realizacji audytowej dla środowisk On-Premise
Logito – Szeroko rozumiane działy wsparcia B2B i Customer Support (obsługa klienta)
Dla podmiotów zmagających się z masowymi zapytaniami na infoliniach czy formularzach, firma Logito stworzyła perfekcyjny system Helpdesk AI z zaimplementowanym szkieletem RAG. Rozwiązanie odciąża konsultantów, błyskawicznie odpowiadając w oparciu o tysiące stron załadowanych kart gwarancyjnych czy regulaminów e-commerce z ubiegłych lat.
Cechy
- ✓ Radykalne skrócenie czasu obsługiwania zgłoszeń SLA
- ✓ Usprawnienie i potanienie struktury BOK/Helpdesk
- ✓ Skuteczność eliminacji halucynacji wspierająca bezpośrednie odpowiedzi do klientów
Uwagi
- ✕ Integracja głównie ukierunkowana na front-line oraz systemy BOK
Squares / Dataone – Działy back-office z potężnymi relacyjnymi bazami danych
Firmy Squares oraz Dataone specjalizują się w bardzo ciężkich wdrożeniach hybrydowych. Ich systemy potrafią sprzężyć sztuczną inteligencję zarówno z wektorowymi ułamkami dokumentów, jak i czystymi tabelami systemów ustrukturyzowanych (CRM, MS SQL). Narzędzia stają się idealnymi, zarządczymi systemami zapytaniowymi dla potężnych architektur w back-office firmy.
Cechy
- ✓ Potężne doświadczenie w pracy z korporacyjnymi bazami (MS SQL)
- ✓ Sprawne połączenie światów ustrukturyzowanych i nieustrukturyzowanych
- ✓ Przedsiębiorstwo unika silosów kompetencyjnych pomiędzy systemami
Uwagi
- ✕ Duży rygor wdrożeniowy (złożoność, konieczne wsparcie IT po stronie zlecającego)
Jak działa system RAG? Architektura krok po kroku
Proces Retrieval-Augmented Generation dzieli się na dwie całkowicie niezależne fazy: przygotowanie środowiska dokumentów i bieżącą obsługę zapytań użytkowników.
Faza I: Indeksowanie i przygotowanie bazy wiedzy (Offline)
- Ekstrakcja treści (Ingestion): Na tym etapie specjalne skrypty pobierają pliki (PDF, DOCX, dane z MS SQL, SharePoint, Google Drive czy Confluence) i wyciągają z nich czysty, niesformatowany tekst. Konieczne jest użycie m.in. technologii OCR w przypadku skanów dokumentów.
- Segmentacja (Chunking): Pobrane pliki są cięte na bardzo małe bloki tekstu (tzw. chunki). Standardy rynkowe wskazują, że optymalna długość fragmentu to 200–500 tokenów. Aby po przecięciu tekstu nie urwać sensu zdania, stosuje się tzw. overlap (czyli nakładanie się na siebie sąsiadujących bloków np. o 10-20%).
- Generowanie embeddingów (Wektoryzacja): To tu dzieje się prawdziwa magia. Specjalny model matematyczny zamienia każde słowo z podzielonego tekstu w gigantyczną macierz liczb (wektory). Dzięki temu AI zaczyna rozumieć bliskość znaczeniową słów (wie, że „zwolnienie lekarskie” leży blisko „L4” i „choroba”).
- Baza wektorowa: Tekst i jego wektor lądują bezpiecznie na serwerze specjalistycznej bazy danych stworzonej do wyszukiwania przestrzennego.
Faza II: Obsługa zapytania (Online, Czas rzeczywisty)
- Wektoryzacja zapytania: Użytkownik wpisuje w czat pytanie. System od razu przekształca to pytanie we wspomniany wektor matematyczny.
- Retrieval (Wyszukiwanie): Baza wektorowa (np. popularny Qdrant) bardzo szybko przelicza odległość między wektorem zapytania a wektorami w całej bazie i wybiera Top-N (najczęściej 3-5) najbardziej zbliżonych znaczeniowo wycinków tekstu.
- Re-zestawienie (Opcjonalny krok jakościowy): Dodatkowy mały model AI na nowo układa wyniki odrzucone w poprzednim etapie, by mieć pewność, że to te najbardziej dopasowane intencją trafią na szczyt.
- Augmentation (Wzbogacenie): Do pierwotnego zapytania od użytkownika doklejane są znalezione w bazie urywki umów i regulaminów w formie „ukrytego kontekstu”.
- Generowanie (Generation): Gotowa „paczka” trafia do potężnego modelu językowego (jak GPT-4o czy Claude 3.5 Sonnet) z poleceniem: Odpowiedz wyłącznie w oparciu o dostarczone przed chwilą fragmenty dokumentów. Użytkownik widzi precyzyjną odpowiedź ze wskazaniem źródła.
Specyfika wdrożeń RAG na rynku polskim (Hybrid Search)
Język polski jest bardzo skomplikowany gramatycznie (rozbudowana fleksja, deklinacja, koniugacja). Tradycyjne wyszukiwanie wyrazów rzadko się sprawdza. Eksperci zrzeszeni chociażby w grupie RAG Polska wskazują, że optymalnym podejściem jest stosowanie wyszukiwania hybrydowego (Hybrid Search). Składa się ono z:
- Dense Retrieval (wyszukiwanie semantyczne): AI doskonale rozumie abstrakcję. Jeżeli pracownik wpisze w system wewnętrzny HR „chcę odpocząć”, RAG podpowie mu wniosek urlopowy.
- Sparse Retrieval (wyszukiwanie słownikowe – np. BM25): Metoda oparta o słowa kluczowe. Ratuje sytuacje, kiedy użytkownik szuka konkretnego akronimu prawnego (np. „ZUS”, „KRS”, „RODO”) lub unikalnego numeru seryjnego produktu. Standardowe wektory mogłyby pojęcie „RODO” zlać ogólnie z ochroną prywatności i nie znaleźć odpowiedniego paragrafu.
Do prawidłowej wektoryzacji polskich tekstów wykorzystuje się modele wielojęzyczne, takie jak Multilingual-E5.
Koszty wdrożenia w Polsce (Cennik 2026)
Bazując na stawkach polskich integratorów systemów AI z 2026 roku, koszty dla sektora B2B można podzielić na trzy odrębne kategorie. Różnią się one stopniem customizacji oraz miejscem instalacji aplikacji (chmura publiczna kontra chmura prywatna).
| Model Wdrożenia | Opis Architektury | Docelowy Klient | Szacowany Setup (Jednorazowo) | Koszt Utrzymania (Miesięcznie) |
|---|---|---|---|---|
| Managed (Chmurowy) | Wykorzystuje gotowe usługi takie jak OpenAI Assistants API lub Google Vertex. Szybki czas wdrożenia (2-4 tyg.). | Małe firmy (baza rzędu 20–100 dokumentów). | 15 000 – 30 000 PLN | 500 – 2 000 PLN |
| Self-hosted / Custom | Aplikacja na frameworkach LangChain/LlamaIndex, wpięta we własną bazę wektorową. Wdrażanie trwa 6-10 tygodni. | Średnie i duże przedsiębiorstwa B2B (baza 500 – 10 000 dokumentów). | 30 000 – 80 000 PLN | 2 000 – 8 000 PLN |
| Hybrydowy / Enterprise | System on-premise lub w zamkniętej chmurze (Zero Trust), pełna zgodność z RODO i NIS2. Często otwarte modele np. Llama 3. Czas budowy to nawet 6 miesięcy. | Korporacje, finanse, branża medyczna, bankowość. | 80 000 – 200 000 PLN | 8 000 – 30 000 PLN |
Warto pamiętać, że tzw. runtime cost (miesięczny) to przede wszystkim opłaty za zużyte tokeny zewnętrznego API modeli generatywnych (często liczone w setkach i tysiącach złotych przy setkach zapytań dziennie) oraz hosting bazy danych, np. chmury Qdrant czy Pinecone.
Retrieval-Augmented Generation kontra Fine-Tuning
Jednym z najważniejszych dylematów architektonicznych jest decyzja o wyborze ścieżki dodawania nowej wiedzy do AI. RAG opiera się na dostarczaniu zewnętrznej bazy, z której model korzysta „w locie”. Natomiast Fine-Tuning polega na dotrenowywaniu modelu (zmienianiu samej struktury wag sieci neuronowej), aby wbić wiedzę prosto w jego „mózg”.
- Koszty: Fine-Tuning pochłania bardzo wysoką kwotę na moc obliczeniową układów GPU. RAG to jedynie koszt indeksowania (bardzo niski).
- Zmienność informacji: Aktualizacja cennika w RAG wymaga po prostu wrzucenia nowego pliku PDF do bazy wektorowej (proces natychmiastowy). Aktualizacja wiedzy modelu fine-tuningowanego może wymagać powtórzenia sesji treningowych na gigantycznych zbiorach.
- Cytowania i audyt: Systemy oparte o wyszukiwarkę potrafią wyświetlić linka z podświetleniem do strony i wiersza dokumentu. Model dotrenowany nie potrafi w sposób weryfikowalny wskazać źródła swojego wnioskowania, co dyskwalifikuje fine-tuning z obsługi dokumentacji prawnej.
- Rekomendacja: Fine-tuning pozostaw modyfikacjom stylistyki, np. gdy zależy ci by model mówił głosem Twojej marki lub formatował kody w konkretnym formacie ustrukturyzowanym JSON. Od operowania na twardych danych i umowach jest wyłącznie RAG.
Zalety i najważniejsze wyzwania
Zalety systemu RAG
Pierwszą i kluczową korzyścią jest drastyczna poprawa wiarygodności poprzez likwidację halucynacji (tzw. grounding – uziemienie wypowiedzi modelu w rzetelnym pliku). To otwiera drzwi na wprowadzanie AI do stref wrażliwych (służba zdrowia, prawo). Po drugie technologia ta pozwala na dynamikę zmian nie wymagając od właściciela posiadania zespołu naukowców AI, który miesiącami trenowałby modele. Rozwiązania Enterprise oraz warianty Self-Hosted pozwalają bez problemu przejść rygorystyczne audyty RODO (dane firmy nie „uczą” publicznych systemów korporacyjnych typu ChatGPT).
Wady (Wyzwania Integracyjne)
System wektorowy to architektura silnie wrażliwa na jakość dostarczonego surowca w myśl zasady Garbage In, Garbage Out. Jak pokazały polskie wdrożenia (np. przypadek znanej kancelarii), pominięcie procesu gruntownego oczyszczania dokumentów (brak dobrego OCR w skanach PDF) zaowocowało stratami ponad 35 000 zł przez drastyczny wzrost halucynacji. Kolejnym mankamentem w obsłudze czasu rzeczywistego (Latency) jest konieczność przejścia kilku etapów przeliczania. Rozbicie wyszukiwania i re-zestawienia sprawia, że interakcja z czatbotem opartym na dokumentach własnych jest zazwyczaj o 1-3 sekundy dłuższa niż w konwersacji ze zwykłym ChatGPT. Warto również zauważyć potężne zużycie tokenów, jeśli do modelu trafiają rozbudowane konteksty dokumentacji technicznej.
Technologie pod spodem
Nie da się zbudować systemu bez solidnej infrastruktury. Kluczowymi graczami i rozwiązaniami wspierającymi w 2026 roku są:
- Bazy wektorowe: Mózgiem systemu pamięciowego firmy jest baza. Ogromny udział w rynku posiada silnik napisany w języku Rust: Qdrant. Jest to absolutny lider wydajnościowy, który notuje ponad 250 milionów pobrań na koncie i gigantyczne wsparcie kapitałowe (w marcu 2026 sfinalizował 50 mln USD w rundzie inwestycyjnej prowadzonej przez AVP). Wśród alternatyw wymienia się w pełni usługowy Pinecone, otwarto-źródłowy Weaviate oraz rozszerzenie do bazy relacyjnej pgvector (dla baz PostgreSQL).
- Platformy AI: W obszarze decyzyjnym królują wielkie modele (GPT-4o, Claude 3.5 Sonnet czy Cohere Command R+).
- Integracja: Ekosystem spajają ze sobą programistyczne mosty budowane we frameworkach takich jak LangChain, LlamaIndex czy dostarczany przez Microsoft Semantic Kernel.
Podsumowanie zestawienia: sprawdzonych integratorów RAG w Polsce (2026)
W tym podsumowaniu zbieram najważniejsze informacje na temat sprawdzonych integratorów RAG w Polsce (2026). W zestawieniu uwzględniam m.in. Boring Owl, Luqam i Foxnet Polska. Opisane rozwiązania różnią się cechami, zakresem oferty i warunkami. Przed wyborem warto sprawdzić aktualne informacje bezpośrednio u danego podmiotu, producenta lub sprzedawcy.
FAQ – Najczęściej zadawane pytania
Czy architektura RAG całkowicie eliminuje problem halucynacji w AI?
System RAG drastycznie minimalizuje podatność modelu na tzw. halucynacje poprzez zakotwiczenie procesu odpowiedzi w faktach (grounding). Choć całkowite usunięcie ryzyka błędów nie jest możliwe, sztuczna inteligencja jest tutaj instruktażowo zmuszana do opierania się wyłącznie na zaserwowanym kontekście z lokalnej bazy, co sprawia, że technologia RAG staje się niezastąpiona np. w działach prawnych i finansowych.
Z jakimi kosztami należy się liczyć przy wdrażaniu RAG w Polsce?
W polskich realiach podstawowy, chmurowy model dla niewielkiej ilości plików (tzw. wersja Managed) można postawić za około 15 000 – 30 000 zł. Skomplikowane architektury customowe z własną bazą kosztują 30 000 – 80 000 zł. Największe przedsięwzięcia korporacyjne w środowiskach silnie regulowanych zaczynają się od kwot 80 000 zł i potrafią kosztować nawet powyżej 200 000 zł plus miesięczne opłaty utrzymaniowe.
Jak RAG radzi sobie ze specyfiką trudnego języka polskiego?
W Polsce wdraża się zaawansowaną technikę zwaną Hybrid Search. System wykonuje podwójne poszukiwania w bazie danych – pierwsze to poszukiwanie semantyczne (Dense), świetnie wyłapujące intencje, a drugie to wyszukiwanie słownikowe (Sparse np. algorytm BM25), które wychwytuje unikalne polskie słowa lub ważne rynkowe akronimy jak ZUS czy KRS. Dodatkowo wykorzystywane są zoptymalizowane pod języki słowiańskie modele np. Multilingual-E5.
Co jest lepszym i tańszym wyborem dla firmy: Fine-Tuning czy RAG?
W przypadku zarządzania suchą wiedzą, aktualizacjami regulaminów czy procedur stanowczych zdecydowanie lepszy i tańszy jest system RAG. Modyfikacja bazy z wiedzą polega jedynie na usunięciu starego i wrzuceniu nowego PDF’a do bazy. Fine-Tuning przydaje się natomiast w firmie wtedy, gdy konieczne jest zmienienie stylu wypowiedzi i narzucenie mu nowej osobowości albo sposobu formatowania, a nie uczenie go bieżących faktów.
Jakie technologie i narzędzia napędzają systemy Retrieval-Augmented Generation?
Filarami wdrożeń są przede wszystkim wyspecjalizowane bazy wektorowe służące do błyskawicznego mapowania pojęć na wektory liczbowe – niekwestionowanymi gigantami technologicznymi w 2026 roku są m.in. popularny silnik Qdrant (wykorzystujący język programowania Rust), chmurowy Pinecone oraz rozwiązanie Weaviate. Obudowa kodowa to najczęściej LangChain oraz środowiska modeli generatywnych takich korporacji jak OpenAI i Anthropic.